متا به هوش مصنوعی چهره و صدای زنده میدهد؛ آواتارهای دیجیتال وارد مکالمه واقعی میشوند
شرکت متا از قابلیت جدیدی برای دستیار هوش مصنوعی Muse رونمایی کرده است که امکان مکالمه صوتی زنده همراه با نمایش آواتارهای متحرک و دارای حالات چهره را فراهم میکند.
شرکت متا در تازهترین بهروزرسانی دستیار هوش مصنوعی خود، Muse، امکان مکالمه صوتی زنده و تعامل با آواتارهای متحرک را اضافه کرده است. با این قابلیت، کاربران میتوانند بهجای تایپ سؤال و دریافت پاسخ متنی، مستقیماً با هوش مصنوعی صحبت کنند و همزمان شخصیت دیجیتالی آن را در قالب یک تصویر متحرک مشاهده کنند.
متا در اطلاعیه رسمی خود در ۵ نوامبر ۲۰۲۶ اعلام کرد که این قابلیت برای اپلیکیشن Muse در موبایل، وب و رایانههای مک عرضه میشود. عرضه اولیه در آمریکا آغاز شده و شرکت هنوز از دسترسی عمومی این قابلیت در سایر کشورها خبر نداده است.
Muse چگونه به هوش مصنوعی چهره و صدا میدهد؟
فناوری جدید متا بر پایه ترکیب دو سامانه هوش مصنوعی ساخته شده است:
-
Muse Realtime Voice: مسئول پردازش مکالمه و تولید پاسخ صوتی در لحظه است.
-
Muse Realtime Avatar: صدای تولیدشده را به حرکات تصویری هماهنگ تبدیل میکند و حالات چهره و حرکات شخصیت دیجیتال را میسازد.
بر اساس توضیحات فنی منتشرشده در وبلاگ پژوهشی متا، این دو فناوری از جریان اطلاعات مشترکی استفاده میکنند تا صدای تولیدشده با حرکات لب و حالات چهره آواتار هماهنگ باشد.
در واقع، سیستم فقط یک تصویر متحرک را روی صدای هوش مصنوعی قرار نمیدهد؛ بلکه تصویر و صدا بهصورت هماهنگ و در جریان مکالمه تولید میشوند.
آواتارهای متا فقط به چهره انسان محدود نیستند
یکی از ویژگیهای قابلتوجه این فناوری، امکان تبدیل انواع تصاویر به شخصیتهای تعاملی است.
متا در معرفی فنی Muse Realtime Avatar اعلام کرده که این فناوری میتواند از یک تصویر مرجع برای ساخت آواتار زنده استفاده کند. این تصاویر میتوانند شامل موارد زیر باشند:
-
تصویر چهره انسان
-
شخصیتهای کارتونی و طراحیشده
-
تصاویر حیوانات
-
اشیای روزمره
آواتارها هنگام مکالمه میتوانند حالات چهره، حرکات دست و تغییر وضعیت بدن داشته باشند. متا همچنین اعلام کرده که تلاش کرده ظاهر و رفتار شخصیت در طول مکالمه ثابت و یکپارچه باقی بماند.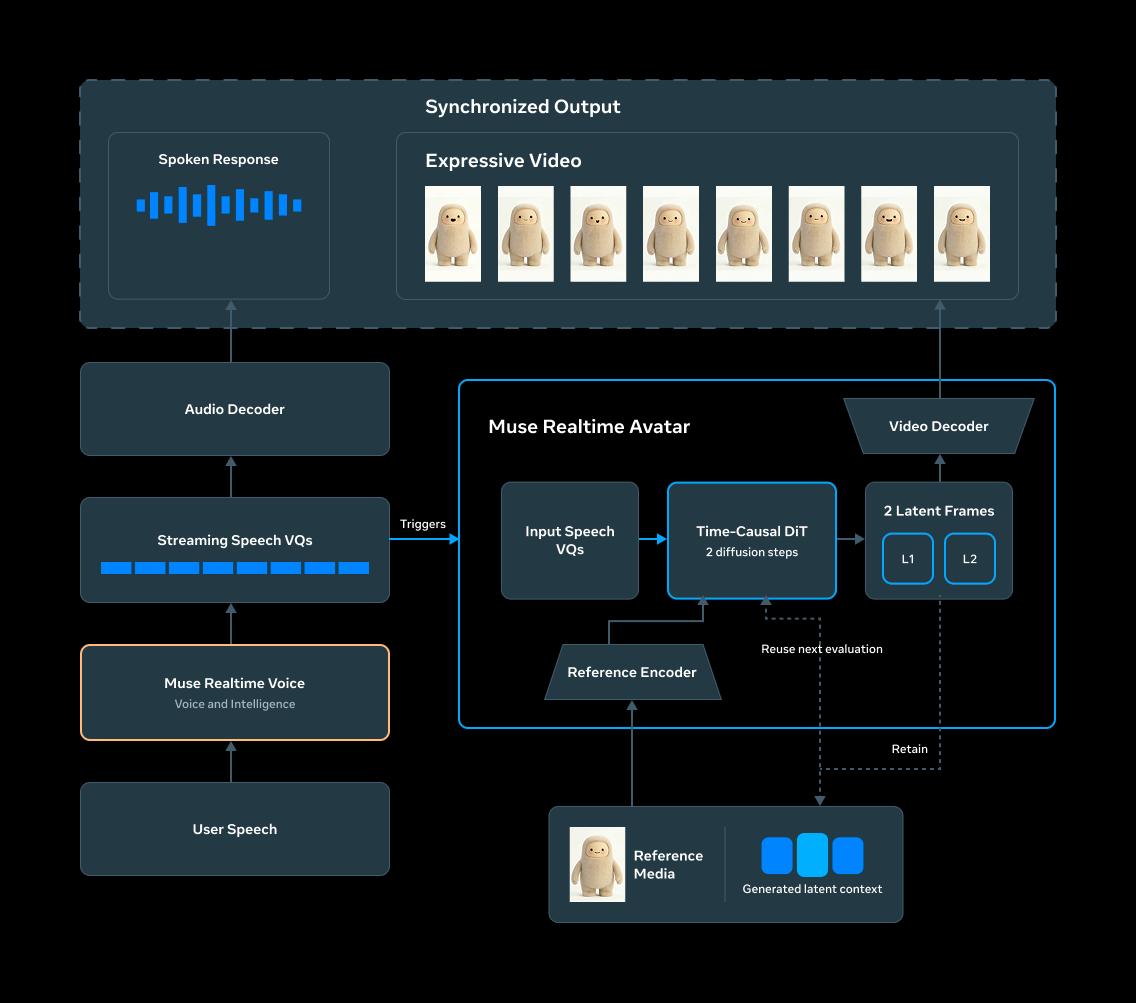
پاسخگویی در کمتر از یک ثانیه؛ جزئیات فنی فناوری جدید
متا در گزارش فنی خود اطلاعات جالبی درباره عملکرد Muse Realtime Avatar منتشر کرده است.
بر اساس این گزارش:
|
مشخصات |
مقدار |
|---|---|
|
وضوح تصویر عمودی |
۴۴۸ در ۷۶۸ پیکسل |
|
نرخ تولید تصویر |
۲۵ فریم در ثانیه |
|
تأخیر تقریبی پاسخ تصویری و صوتی |
۸۷۰ میلیثانیه |
|
سختافزار آزمایششده |
NVIDIA GB200 |
این اعداد مربوط به اندازهگیری و شرایط آزمایش اعلامشده توسط متا هستند و نباید بهعنوان عملکرد تضمینشده در تمام دستگاهها و شرایط اینترنت در نظر گرفته شوند.
نکته فنی دیگر، استفاده از معماری Diffusion Transformer و روشهای بهینهسازی تولید ویدئو است. متا میگوید با استفاده از تکنیک تقطیر مدل، تعداد ارزیابیهای موردنیاز برای تولید هر بخش ویدئو از ۱۲۰ به ۲ مرحله کاهش یافته است؛ یعنی کاهش ۶۰ برابری در این بخش از فرایند محاسباتی
آیا میتوان صدای هوش مصنوعی را تغییر داد؟
بله. متا اعلام کرده که کاربران میتوانند از میان صدها گزینه صوتی، صدای موردنظر خود را انتخاب کنند و سبک گفتار دستیار را تغییر دهند.
برای مثال، میتوانند صدایی با لحن پرانرژیتر یا سبک گفتاری متفاوت انتخاب کنند.
در زمان مکالمه نیز کاربر میتواند صحبت هوش مصنوعی را قطع کند و سؤال یا درخواست دیگری مطرح کند. همچنین امکان استفاده از Muse در سه حالت وجود دارد:
1. مکالمه صوتی بدون نمایش آواتار
2. نمایش آواتار در کنار محیط گفتوگو
3. نمایش تمامصفحه شخصیت دیجیتال برای مکالمه تصویری
این قابلیت باعث میشود تعامل با دستیار هوش مصنوعی بیشتر به یک گفتوگوی زنده شباهت پیدا کند.
آیا فناوری جدید متا خطر جعل هویت دیجیتال را افزایش میدهد؟
این بخش از خبر برای تحریریه امنیت سایبری اهمیت بیشتری دارد.
فناوری تولید آواتارهای زنده، در کنار کاربردهای مفیدی مانند آموزش، سرگرمی و خدمات مشتریان، یک موضوع مهم امنیتی را نیز برجسته میکند: دشوارتر شدن تشخیص محتوای واقعی از محتوای تولیدشده با هوش مصنوعی.
وقتی یک سامانه میتواند از تصویر مرجع، شخصیتی متحرک با حرکات طبیعی بسازد، مرز میان تصویر ثابت و شخصیت دیجیتال تعاملی کمرنگتر میشود.
با این حال، باید میان قابلیت واقعی محصول و سناریوهای احتمالی سوءاستفاده تفاوت قائل شد.
آنچه درباره Muse تأیید شده است:
-
امکان ساخت آواتارهای تعاملی با استفاده از تصاویر مرجع وجود دارد.
-
آواتار میتواند حالات چهره و حرکات بدن داشته باشد.
-
صدا و تصویر در جریان مکالمه هماهنگ میشوند.
آنچه نباید بدون مدرک به این محصول نسبت داد:
-
اینکه Muse بهصورت پیشفرض صدای هر شخصی را شبیهسازی میکند.
-
اینکه میتواند هویت واقعی افراد را بدون اجازه آنها جعل کند.
-
اینکه قابلیت جدید بهتنهایی امکان کلاهبرداری صوتی یا تصویری را فراهم کرده است.
این تمایز اهمیت دارد؛ زیرا انتخاب صدای دستیار از میان گزینههای موجود با شبیهسازی صدای یک فرد واقعی یکسان نیست.
متا برای شناسایی محتوای تولیدشده چه تدبیری در نظر گرفته است؟
یکی از نکات مهم در گزارش پژوهشی متا، استفاده از فناوری Video Seal است.
متا میگوید Muse Realtime Avatar از این فناوری برای درج واترمارک نامرئی و پایدار در ویدئوهای تولیدشده استفاده میکند. هدف از این کار، قابلردیابیتر کردن محتوای تولیدشده توسط سیستم است.
واترمارک نامرئی میتواند به شناسایی منشأ محتوای مصنوعی کمک کند؛ اما نباید آن را تضمینی برای جلوگیری از جعل هویت یا تشخیص قطعی تمام ویدئوهای دستکاریشده دانست.
در نتیجه، وجود این سازوکار امنیتی به معنای حذف کامل خطر سوءاستفاده از آواتارهای هوش مصنوعی نیست.
دسترسی به Muse برای چه کسانی فراهم شده است؟
بر اساس اعلام رسمی متا در ۵ نوامبر ۲۰۲۶، قابلیت صوتی و آواتار در مرحله نخست برای کاربران آمریکا عرضه شده است.
این ویژگی روی نسخههای موبایل، وب و مک اپلیکیشن Muse ارائه میشود. متا همچنین اعلام کرده که در آینده امکان مکالمه صوتی با Muse به عینکهای هوشمند هوش مصنوعی و دستگاه Muse Charm اضافه خواهد شد.
نکته مهم دیگر اینکه صفحه پژوهشی متا، Muse را برای کاربران بالای ۱۸ سال معرفی کرده است. بنابراین نباید عرضه اولیه آن را به معنای دسترسی عمومی همه گروههای سنی یا همه کشورهای جهان دانست.
جمعبندی
قابلیت جدید متا نشان میدهد توسعه هوش مصنوعی از پاسخگویی متنی و صوتی ساده به سمت شخصیتهای دیجیتال تعاملی حرکت کرده است. Muse اکنون میتواند با صدای زنده، حالات چهره و حرکات هماهنگ، تجربهای نزدیکتر به مکالمه رودررو ایجاد کند.
از منظر امنیت سایبری، اهمیت این تحول صرفاً در طبیعیتر شدن مکالمه نیست؛ بلکه در افزایش ظرفیت تولید محتوای تصویری و صوتی مصنوعی و ضرورت توجه بیشتر به اصالت هویت دیجیتال است.
در عین حال، وجود فناوری واترمارک Video Seal و تفاوت میان تولید آواتار و جعل صدای افراد نشان میدهد برای ارزیابی دقیق خطرات این فناوری باید به شواهد فنی تکیه کرد، نه صرفاً ظاهر واقعگرایانه آن.
منابع
منابع زیر در تهیه و راستیآزمایی این گزارش بررسی شدهاند:
۱. متا – منبع رسمی خبر
عنوان: Give Your Muse a Voice
تاریخ: ۵ نوامبر ۲۰۲۶
۲. Meta AI Research – منبع فنی
عنوان: Bringing Your Muse to Life
تاریخ: ۲۳ سپتامبر ۲۰۲۶
مطالعه گزارش فنی Muse Realtime Avatar
۳. TechCrunch – گزارش تکمیلی
عنوان: Meta says US users can now video chat with their Muse AI avatar
تاریخ: ۵ نوامبر ۲۰۲۶
۴. The Verge – گزارش تکمیلی
عنوان: Muse has a voice mode now


