سم آلتمن و آینده کامپیوترهای شخصی؛ رم کاربران یا دیتاسنترهای هوش مصنوعی؟
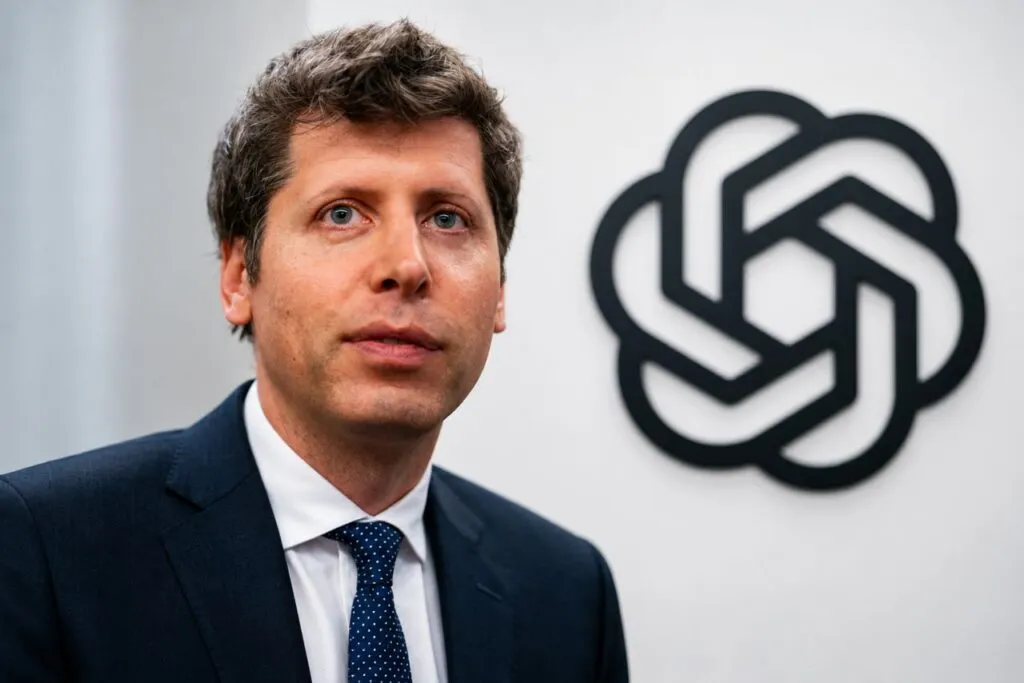
آیا در عصر هوش مصنوعی، منابع پردازشی باید همچنان در اختیار کاربران باقی بمانند یا تمرکز آنها در دیتاسنترهای شرکتهای بزرگ منطقیتر است؟
استدلال آلتمن؛ چرا رم باید در دیتاسنترها استفاده شود؟
سم آلتمن در گفتوگو با پادکست Cheeky Pint، هنگام صحبت درباره کمبود جهانی حافظه و آینده اجرای محلی مدلهای هوش مصنوعی، از رویکردی دفاع کرد که بر استفاده حداکثری از منابع سختافزاری در فضای ابری متمرکز است.
او با اشاره به افرادی که ترجیح میدهند مدلهای هوش مصنوعی را روی کامپیوترهای خود اجرا کنند، گفت از منظر تخصیص جهانی منابع، مناسب نیست بخش بزرگی از ذخیره محدود DRAM در کامپیوترهای شخصی قرار داشته باشد و تنها حدود ۵ درصد مواقع استفاده شود.
از نگاه آلتمن، دیتاسنترها میتوانند حافظه و قدرت پردازش را میان درخواستهای مختلف به اشتراک بگذارند و در نتیجه، از ظرفیت سختافزاری استفاده بیشتری کنند. او این دیدگاه را در چارچوب محدودیت عرضه حافظه مطرح کرد؛ محدودیتی که با افزایش تقاضای شرکتهای هوش مصنوعی برای زیرساخت پردازشی اهمیت بیشتری پیدا کرده است.
مسئله فراتر از رم؛ چه کسی منابع پردازشی را در اختیار دارد؟
اهمیت این اظهارنظر فقط به اختلافنظر درباره میزان استفاده از حافظه محدود نمیشود. بحث اصلی به دو الگوی متفاوت برای آینده محاسبات مربوط است.
در الگوی نخست، کاربران کامپیوتر شخصی خود را خریداری میکنند، ظرفیت رم و پردازنده را متناسب با نیازشان انتخاب میکنند و کنترل اجرای نرمافزارها و مدلهای هوش مصنوعی را در اختیار دارند.
در الگوی دوم، بخش بیشتری از پردازشها در دیتاسنترهای بزرگ انجام میشود و کاربران از طریق اینترنت به قدرت محاسباتی موردنیازشان دسترسی پیدا میکنند. این مدل میتواند استفاده اشتراکی از منابع گرانقیمت را افزایش دهد؛ اما در مقابل، وابستگی کاربران به زیرساخت شرکتهای ارائهدهنده خدمات ابری را نیز بیشتر میکند.
تفاوت این دو رویکرد در واقع تفاوت میان مالکیت مستقیم سختافزار و دسترسی به قدرت پردازش بهعنوان یک سرویس است.
چرا اجرای محلی هوش مصنوعی همچنان اهمیت دارد؟
استدلال آلتمن از منظر مدیریت منابع در مقیاس جهانی قابل بررسی است؛ اما این نگاه تمام مزایای کامپیوترهای شخصی را در نظر نمیگیرد.
اجرای محلی مدلهای هوش مصنوعی میتواند مزایایی مانند کاهش وابستگی به اینترنت، کنترل بیشتر بر دادههای شخصی، دسترسی مستقل به نرمافزارها و کاهش نیاز به پرداخت هزینه اشتراک برای برخی خدمات را فراهم کند.
برای مثال، کاربری که یک مدل هوش مصنوعی را روی کامپیوتر خود اجرا میکند، لزوماً برای هر درخواست به سرورهای یک شرکت خارجی وابسته نیست. این موضوع برای کاربردهای حساس، پردازش اطلاعات شخصی و محیطهایی که اتصال دائمی به اینترنت ندارند اهمیت دارد.
از سوی دیگر، حافظه کامپیوترهای شخصی فقط برای اجرای مدلهای هوش مصنوعی استفاده نمیشود. سیستمعامل، بازیها، مرورگرها، نرمافزارهای مهندسی و ابزارهای تولید محتوا نیز به رم محلی نیاز دارند. بنابراین کماستفاده بودن بخشی از ظرفیت حافظه در برخی ساعات، بهتنهایی به معنای هدررفتن آن نیست.
تضاد منافع؛ شرکتهای هوش مصنوعی چه جایگاهی در این بحث دارند؟
اظهارات آلتمن را نمیتوان جدا از مدل تجاری OpenAI و دیگر شرکتهای بزرگ هوش مصنوعی بررسی کرد. این شرکتها برای آموزش و اجرای مدلهای پیشرفته به زیرساختهای عظیم پردازشی وابستهاند و توسعه خدماتشان به ظرفیت بیشتر دیتاسنترها نیاز دارد.
در چنین شرایطی، گسترش اجرای محلی مدلها میتواند بخشی از پردازشهایی را که اکنون در فضای ابری انجام میشوند، به دستگاه کاربران منتقل کند. این اتفاق ممکن است در برخی کاربردها نیاز به استفاده از سرویسهای ابری را کاهش دهد؛ هرچند مدلهای بزرگ همچنان به زیرساختهای محاسباتی قابلتوجه نیاز خواهند داشت.
به همین دلیل، دیدگاه آلتمن درباره تخصیص حافظه از نظر اقتصادی نیز قابل بررسی است: شرکتی که خدمات اصلی خود را بر زیرساخت ابری ارائه میکند، طبیعتاً از افزایش استفاده از این زیرساختها منتفع میشود.
البته این موضوع بهتنهایی ثابت نمیکند که آلتمن قصد محدود کردن مالکیت سختافزار شخصی را دارد. آنچه در مصاحبه مطرح شده، استدلالی درباره بهرهوری منابع کمیاب است، نه اعلام برنامهای برای انتقال اجباری حافظه کاربران به دیتاسنترها.
تمرکز قدرت پردازش چه پیامدهایی برای کاربران دارد؟
گسترش مدل ابری میتواند دسترسی به ابزارهای قدرتمند هوش مصنوعی را برای کاربرانی که سختافزار گرانقیمت ندارند آسانتر کند. در این الگو، افراد بهجای خرید تجهیزات پردازشی پیشرفته، از طریق اینترنت به منابع یک دیتاسنتر دسترسی پیدا میکنند.
بااینحال، این دسترسی بدون ملاحظات نیست. وابستگی به اینترنت، هزینه اشتراک یا مصرف، سیاستهای ارائهدهنده سرویس و نحوه پردازش و نگهداری دادهها از جمله عواملی هستند که میتوانند تجربه کاربران را تحت تأثیر قرار دهند.
از منظر امنیت و حریم خصوصی نیز اجرای محلی و ابری تفاوتهایی دارند. در اجرای محلی، دادهها میتوانند بدون ارسال به سرور خارجی پردازش شوند؛ درحالیکه استفاده از سرویس ابری معمولاً مستلزم انتقال درخواستها و گاهی دادههای کاربر به زیرساخت ارائهدهنده است. البته میزان این انتقال به طراحی و سیاست هر سرویس بستگی دارد.
بنابراین، افزایش بهرهوری دیتاسنترها لزوماً به معنای برتری آنها در تمام سناریوها نیست. انتخاب میان اجرای محلی و ابری باید با توجه به هزینه، کارایی، امنیت و نیاز کاربر انجام شود.
آینده کامپیوترهای شخصی در عصر دیتاسنترهای هوش مصنوعی
اظهارنظر آلتمن پرسشی اساسی درباره مسیر آینده صنعت فناوری مطرح میکند: آیا کامپیوترهای شخصی همچنان دستگاههایی مستقل با منابع پردازشی متعلق به کاربران باقی میمانند یا بهتدریج به ابزارهایی برای اتصال به قدرت محاسباتی شرکتهای بزرگ تبدیل میشوند؟
احتمالاً پاسخ به این پرسش یک انتخاب صفر و یک نخواهد بود. اجرای محلی برای برخی کاربردها، بهویژه موارد حساس به حریم خصوصی یا نیازمند دسترسی آفلاین، اهمیت خود را حفظ میکند. در مقابل، دیتاسنترها نیز برای اجرای مدلهای بزرگ و ارائه خدمات گسترده ضروری خواهند بود.
بااینحال، هرچه سهم هوش مصنوعی در فعالیتهای روزمره بیشتر شود، رقابت بر سر حافظه، پردازنده، انرژی و ظرفیت دیتاسنترها نیز اهمیت بیشتری پیدا میکند. در چنین شرایطی، بحث درباره محل استفاده از منابع سختافزاری دیگر صرفاً موضوعی فنی نیست؛ بلکه به مسئلهای اقتصادی و مرتبط با حق انتخاب مصرفکنندگان تبدیل میشود.
جمعبندی: حرف سم آلتمن را میتوان دفاع از بهرهوری بیشتر منابع حافظه در دیتاسنترها دانست؛ اما این دیدگاه یک پرسش مهم را بیپاسخ میگذارد: آیا کارآمدتر بودن یک زیرساخت از نگاه شرکتهای فناوری، بهتنهایی برای ترجیح آن بر مالکیت و کنترل سختافزار توسط کاربران کافی است؟ پاسخ به این پرسش، یکی از بحثهای مهم در آینده اقتصاد هوش مصنوعی خواهد بود.


